

Key Takeaways
- robots.txt คือไฟล์ที่ใช้กำหนดกฎการเข้าถึง URL สำหรับ Search Engine Crawler โดยช่วยระบุส่วนของเว็บไซต์ที่อนุญาตหรือไม่อนุญาตให้ Crawler ที่รองรับกฎเข้าถึง
- robots.txt ไม่ใช่เครื่องมือสำหรับสั่งไม่ให้หน้าเว็บติด Google โดยตรง เพราะ URL ที่ถูกบล็อกการ Crawl ยังอาจปรากฏในผลการค้นหาได้ภายใต้บางเงื่อนไข
- การตั้งค่า robots.txt ผิดอาจกระทบ Technical SEO อย่างมาก โดยเฉพาะเมื่อบล็อกหน้าสินค้า หน้าบริการ หรือไฟล์สำคัญที่ Search Engine จำเป็นต้องเข้าถึง
เว็บไซต์มีบทความคุณภาพ มีสินค้าครบ และทำ SEO มาหลายเดือน แต่ทำไม Google กลับเข้าถึงบางหน้าไม่ได้ ทำให้เว็บไซต์เราไม่ไปไหนสักที และแน่นอนว่า นี่คือหนึ่งในจุดที่ควรตรวจสอบคือไฟล์ robots.txt ซึ่งแม้จะเป็นไฟล์ข้อความขนาดเล็ก แต่มีบทบาทสำคัญต่อวิธีที่ Search Engine Crawler เข้าถึงเว็บไซต์ ไม่น้อยเลย
การเข้าใจว่า robots.txt คืออะไร และควรใช้ Allow หรือ Disallow อย่างไร จะช่วยลดความเสี่ยงจากการปิดกั้นหน้าสำคัญโดยไม่ตั้งใจ โดยเฉพาะเว็บไซต์ที่มี URL จำนวนมากหรือระบบหลังบ้านซับซ้อน สำหรับธุรกิจที่ต้องการตรวจสอบปัญหา Crawling และ Indexing อย่างเป็นระบบ รับทำ SEO จาก Convert Cake ครอบคลุม Technical SEO และ Site Audit เพื่อช่วยวิเคราะห์ปัญหาที่อาจส่งผลต่อการมองเห็นเว็บไซต์บน Google
Table of Contents
robots.txt คืออะไร? เครื่องมือควบคุม Web Crawler ที่คนทำ SEO ต้องรู้
ในการทำ Technical SEO การดูแลให้ Search Engine เข้าถึงและจัดเก็บข้อมูลเว็บไซต์ได้อย่างมีประสิทธิภาพถือเป็นเรื่องที่ไม่ควรมองข้าม และหนึ่งในไฟล์หลังบ้านที่มีบทบาทสำคัญที่สุดต่อการสแกนข้อมูลของบอทก็คือ robots.txt ลองมาทำความเข้าใจกลไกการทำงาน บทบาทต่อ SEO และข้อควรระวังในการใช้งานไฟล์นี้อย่างถูกต้องกัน
robots.txt คืออะไร และเกี่ยวข้องอย่างไรกับ SEO
robots.txt คือไฟล์ข้อความธรรมดา (Text File) ที่วางไว้บริเวณ Root Directory ของเว็บไซต์ (เช่น [https://example.com/robots.txt](https://example.com/robots.txt)) ทำหน้าที่ระบุกฎและเงื่อนไขตามมาตรฐาน Robots Exclusion Protocol เพื่อสั่งการ Web Crawlers หรือบอทของ Search Engine ว่ามี URL ส่วนใดบ้างที่อนุญาตให้เข้ามาสแกนข้อมูลได้ หรือส่วนใดที่ไม่ควรเข้าถึง บทบาทสำคัญของ robots.txt ต่อการทำ SEO มีดังนี้
- บริหารจัดการ Crawl Budget: ช่วยประหยัดโควตาการสแกนของบอท ไม่ให้เสียเวลาไปกับหน้าที่ไม่จำเป็น เช่น หน้าตะกร้าสินค้า หน้าค้นหาภายในเว็บ หรือหน้าแอดมินหลังบ้าน
- ลดการทำงานหนักของเซิร์ฟเวอร์: ป้องกันไม่ให้บอทเข้ามา Crawl หน้าสคริปต์หรือไฟล์ขนาดใหญ่พร้อมกันจนเซิร์ฟเวอร์ชะลอตัว
- ปกป้องโครงสร้างเว็บเบื้องต้น: ซ่อนเส้นทางไฟล์ส่วนตัวหรือหน้าทดสอบระบบไม่ให้บอทไต่เข้าไปสแกนโดยง่าย
โดยมีข้อควรระวัง ดังนี้ ไฟล์ robots.txt ไม่ใช่ระบบรักษาความปลอดภัยของข้อมูล และไม่สามารถป้องกันบอทสายมืดหรือปั่นสแปมที่ไม่ปฏิบัติตามกฎมาตรฐานได้
robots.txt ทำงานร่วมกับ Googlebot อย่างไร
ก่อนที่ Googlebot จะทำการสแกนและเก็บข้อมูล (Crawl) หน้าเว็บใด ๆ ระบบจะทำการวิ่งเข้ามาอ่านไฟล์ robots.txt ที่ Root Directory ก่อนเป็นอันดับแรกเสมอ เพื่อตรวจสอบว่ามีคำสั่งจำกัดสิทธิ์การเข้าถึงในเส้นทางนั้นหรือไม่
หากไฟล์มีการระบุคำสั่ง Disallow: สำหรับโฟลเดอร์หรือ URL นั้นไว้ Googlebot จะข้ามการสแกนเนื้อหาภายในหน้านั้นทันทีตามหลักเกณฑ์ที่กำหนดไว้ ตัวอย่างเช่น การสั่ง Disallow หน้าผลลัพธ์การค้นหาภายในเว็บไซต์ (Internal Search Results) เพื่อไม่ให้สร้าง URL ขยะจำนวนมากในระบบ
อย่างไรก็ตาม การตั้งค่าคำสั่ง Disallow จำเป็นต้องพิจารณาอย่างรอบคอบ เพราะหากเผลอบล็อกโฟลเดอร์สำคัญ เช่น ไฟล์ CSS, JavaScript หรือรูปภาพหลัก อาจส่งผลให้ Googlebot ประมวลผลหน้าเว็บผิดพลาด และกระทบต่ออันดับบนหน้าค้นหาได้
เปรียบเทียบความแตกต่าง: robots.txt vs noindex vs Sitemap
แม้ทั้งสามเครื่องมือจะทำงานร่วมกันเพื่อสนับสนุนการทำ Technical SEO แต่ก็มีบทบาทและกลไกการทำงานที่แตกต่างกันอย่างสิ้นเชิง การเลือกใช้ผิดวัตถุประสงค์อาจส่งผลเสียต่อเว็บไซต์ได้:
เครื่องมือ | หน้าที่หลัก | ข้อควรระวังในการใช้งาน |
robots.txt | ควบคุมการเข้าถึงและกักบริเวณการ Crawl ของบอท | ไม่รับประกันว่า URL จะไม่ปรากฏบน Google (หากมีลิงก์จากภายนอกชี้มา หน้าเว็บก็อาจถูก Index แค่ชื่อ URL ได้) |
noindex | คำสั่งแจ้ง Search Engine ไม่ให้นำหน้าเว็บไปทำดัชนี (Index) | บอทต้องสามารถไต่เข้าไปอ่านคำสั่งนี้ในหน้าเว็บได้ (ห้ามบล็อกด้วย robots.txt) |
Sitemap | ยื่นแผนที่แสดงรายการ URL สำคัญที่ต้องการให้สแกน | เป็นเพียงการแจ้งเบาะแส ไม่รับประกันว่าจะถูก Index ทุกหน้า |
ข้อผิดพลาดที่พบบ่อยที่สุดคือการใช้คำสั่ง Disallow ใน robots.txt เพราะเข้าใจว่าจะช่วยซ่อนหน้าเว็บจาก Google ได้ ซึ่งเป็นความเข้าใจผิด หากต้องการไม่ให้หน้าเว็บปรากฏบนผลการค้นหาอย่างแท้จริง ควรใช้แท็ก <meta name=”robots” content=”noindex”> หรือการใส่รหัสผ่านป้องกันแทน เนื่องจากหาก Googlebot ถูกบล็อกด้วย robots.txt ตั้งแต่แรก บอทจะไม่สามารถไต่เข้าไปอ่านคำสั่ง noindex ที่ซ่อนอยู่ในหน้านั้นได้เลย
วิธีสร้าง robots.txt และตั้งค่า Allow, Disallow อย่างถูกต้อง
การจัดทำไฟล์ robots.txt สามารถทำได้อย่างง่ายดายด้วยไฟล์ข้อความธรรมดา (.txt) แต่เบื้องหลังความง่ายนั้นจำเป็นต้องอาศัยความแม่นยำสูง เนื่องจากคำสั่งเพียงบรรทัดเดียวในไฟล์นี้สามารถส่งผลกระทบต่อการเข้าถึงของ Search Engine ได้ทั้งเว็บไซต์ ก่อนนำไปติดตั้งและใช้งานจริง ลองมาดูโครงสร้างพื้นฐาน ไวยากรณ์สำคัญ และตัวอย่างการตั้งค่าอย่างถูกต้องกัน
โครงสร้างและคำสั่งสำคัญในไฟล์ robots.txt
การเขียนไฟล์ robots.txt จะใช้วิธีการกำหนดกลุ่มกฎ (Rule Sets) โดยจับคู่ระหว่างประเภทของบอทและขอบเขตการเข้าถึง ซึ่งมีคำสั่งหลักที่ควรรู้ดังนี้
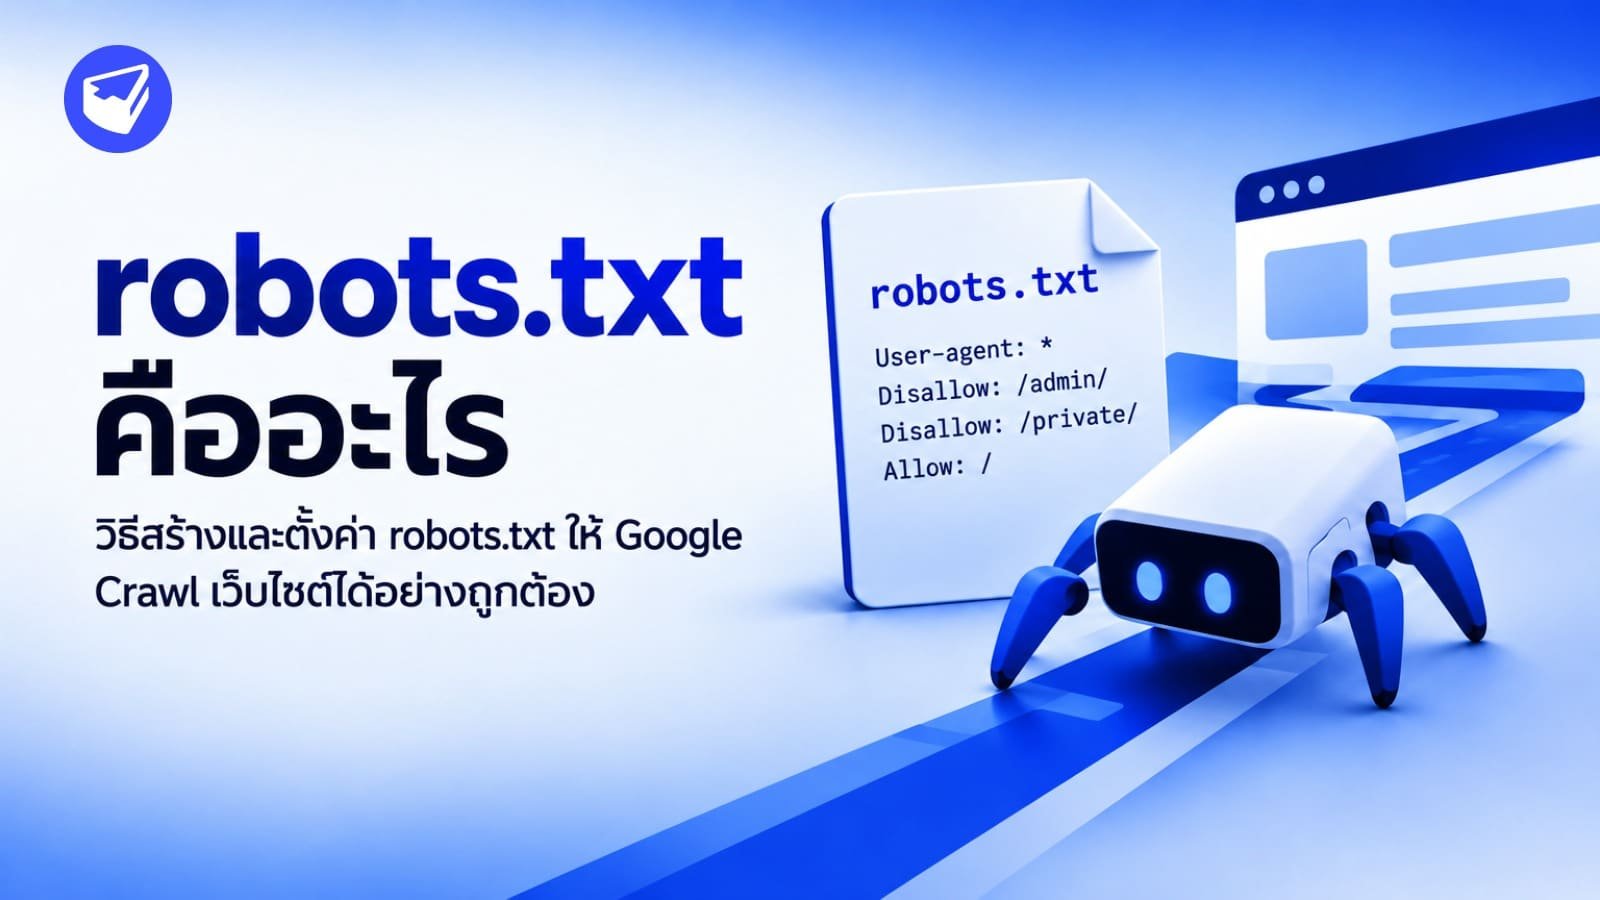
- User-agent: ใช้ระบุชื่อของ Web Crawler ที่ต้องการบังคับใช้กฎ เช่น Googlebot สำหรับ Google หรือใช้เครื่องหมาย * เพื่อหมายถึง Crawler ทุกชนิดในระบบ
- Disallow: ใช้ระบุเส้นทาง โฟลเดอร์ หรือ URL ที่ ไม่ต้องการ ให้ Crawler เข้าไปสแกนข้อมูล
- Allow: ใช้ระบุเส้นทางที่ อนุญาต ให้เข้าถึงได้ ซึ่งมักใช้ปลดล็อกโฟลเดอร์ย่อยหรือไฟล์เฉพาะทางที่ซ้อนอยู่ภายใต้โฟลเดอร์ที่โดนสั่ง Disallow ไว้
- Sitemap: ใช้ระบุที่อยู่ Absolute URL ของไฟล์ Sitemap เพื่อช่วยชี้ทางให้บอทค้นหาแผนผังเว็บไซต์ได้ทันทีที่เข้ามาเก็บข้อมูล
ตัวอย่างการเขียนและตั้งค่า robots.txt ใช้งานจริง
ตัวอย่างไฟล์ที่เปิดให้ Crawler เข้าถึงได้ทั้งเว็บไซต์
สำหรับการเปิดให้ Crawler เข้าถึงได้ทั้งเว็บไซต์ หากต้องการให้บอททุกตัวเข้ามาสแกนข้อมูลได้ทุกหน้าโดยไม่มีข้อจำกัด สามารถตั้งค่าด้วยการระบุ User-agent: * เพื่อครอบคลุมบอททั่วไป พร้อมเว้นว่างหลังคำสั่ง Disallow: เพื่อไม่กำหนดเส้นทางห้ามเข้า และปิดท้ายด้วยการระบุ Sitemap: [https://example.com/sitemap.xml](https://example.com/sitemap.xml) ซึ่งรูปแบบนี้จะช่วยให้บอทเปิดเข้าถึงและสแกนข้อมูลได้ทั่วทั้งเว็บอย่างอิสระ
ตัวอย่างการบล็อกเฉพาะโฟลเดอร์ที่ไม่ต้องการให้สแกน
สำหรับการบล็อกเฉพาะโฟลเดอร์ที่ไม่ต้องการให้สแกน ในกรณีที่เว็บไซต์มีเส้นทางหรือระบบภายในที่ไม่อยากให้บอทเสียเวลาเข้ามาเก็บข้อมูล เช่น หน้าค้นหาภายในระบบอย่าง /internal-search/ สามารถกำหนดค่าผ่าน User-agent: * ตามด้วย Disallow: /internal-search/ และระบุลิงก์ Sitemap ควบคู่กันไป ซึ่งคำสั่งนี้จะส่งผลให้บอททุกตัวถูกห้ามไม่ให้ไต่เข้าไปในโฟลเดอร์ดังกล่าวรวมถึง URL ทั้งหมดที่ซ้อนอยู่ภายในเส้นทางนั้น
ตัวอย่างการใช้ Allow ร่วมกับ Disallow (ยกเว้นบางหน้า)
สำหรับการใช้คำสั่ง Allow ร่วมกับ Disallow เพื่อยกเว้นเฉพาะบางหน้า หากมีความจำเป็นต้องบล็อกโฟลเดอร์ขนาดใหญ่แต่ต้องการเปิดให้บอทเข้าถึงไฟล์หรือหน้าย่อยบางจุด เช่น การบล็อกระบบหลังบ้านทั้งหมดแต่ยกเว้นหน้าล็อกอิน สามารถเขียนคำสั่งควบคุมด้วยการระบุ Disallow: /admin/ ควบคู่กับ Allow: /admin/login.php ซึ่งระบบจะสั่งการให้บอทหลีกเลี่ยงการสแกนโฟลเดอร์หลัก ยกเว้นไฟล์เฉพาะเจาะจงที่ได้รับอนุญาตให้เข้าถึงได้เท่านั้น
ข้อควรระวังเรื่องความปลอดภัยในการตั้งค่า
สำหรับข้อควรระวังด้านความปลอดภัย ห้ามใช้ไฟล์ robots.txt เป็นเครื่องมือในการซ่อนข้อมูลลับ ข้อมูลส่วนบุคคล หรือหน้าแอดมินระดับลึกเด็ดขาด เนื่องจากไฟล์ robots.txt เป็นไฟล์สาธารณะที่ทุกคนสามารถเปิดดูผ่านเบราว์เซอร์ได้โดยอิสระ อีกทั้งบอทที่ไม่ประสงค์ดีอาจใช้ข้อมูลจากคำสั่ง Disallow ในการสแกนหาจุดอ่อนของเว็บไซต์ได้เช่นกัน
robots.txt ส่งผลต่อ Crawling, Indexing และ Crawl Budget อย่างไร
การจัดการไฟล์ robots.txt มีความเกี่ยวข้องโดยตรงกับกระบวนการ Crawl ของ Search Engine แต่ต้องทำความเข้าใจให้ชัดเจนว่าการควบคุมการเข้าถึง (Crawling) กับการทำดัชนี (Indexing) เป็นคนละกระบวนการกัน การบล็อกหน้าเว็บด้วย robots.txt ไม่ได้แปลว่าหน้านั้นจะหายไปจากผลการค้นหาเสมอไป
สำหรับการบริหารจัดการ Crawl Budget ในเว็บไซต์ขนาดใหญ่ การจำกัดการ Crawl เส้นทางที่ไม่จำเป็นช่วยลดคำขอซ้ำซ้อนและจัดสรรโควตาของบอทให้มีประสิทธิภาพขึ้น แต่สำหรับเว็บไซต์ขนาดเล็กที่ไม่พบปัญหาเรื่องโควตาสแกน ไม่ควรบล็อก URL สุ่มสี่สุ่มห้า เพราะอาจทำให้ Google พลาดการเข้าถึงเนื้อหาสำคัญ นอกจากนี้ หากพบว่าหน้าเว็บที่บล็อกด้วย robots.txt ยังคงปรากฏบน Google นั่นเป็นเพราะ Googlebot ค้นพบ URL นั้นจากลิงก์ภายนอก หากต้องการป้องกันการทำดัชนีอย่างแท้จริง จึงควรใช้คำสั่ง noindex บนหน้าที่ Crawler เข้าถึงได้แทนการใช้ Disallow
สำหรับองค์กรหรือแบรนด์ที่ต้องการวางโครงสร้างหลังบ้าน ปรับแต่ง Technical SEO หรือวางกลยุทธ์เพื่อใช้ Crawl Budget ให้คุ้มค่าที่สุด การเลือกปรึกษา 15 บริษัทรับทำ SEO ชั้นนำในไทย ที่มีความเชี่ยวชาญเฉพาะทางจะช่วยลดความเสี่ยงในการตั้งค่าผิดพลาด และช่วยให้ระบบเว็บไซต์ทำงานได้อย่างสมบูรณ์แบบตั้งแต่รากฐาน
วิธีตรวจสอบ robots.txt และข้อผิดพลาดที่ต้องระวังเพื่อป้องกัน SEO พัง
ก่อนเผยแพร่หรือปรับแก้ไฟล์ robots.txt ทุกครั้ง เจ้าของเว็บไซต์ควรตรวจสอบผลกระทบของชุดคำสั่งที่มีต่อ URL สำคัญอย่างละเอียด เพื่อป้องกันความเสียหายที่อาจเกิดขึ้นกับภาพรวมของเว็บไซต์และการจัดอันดับในการทำ SEO ในระยะยาว แนวทางการตรวจสอบเบื้องต้นผ่าน Google Search Console และระบบหลังบ้าน สามารถทำได้ผ่านขั้นตอนสำคัญ ดังนี้
- เปิดเข้าลิงก์ /robots.txt โดยตรงเพื่อเช็กสถานะการตอบสนองของเซิร์ฟเวอร์
- ตรวจสอบคำสั่ง User-agent, Allow และ Disallow ว่าตรงตามวัตถุประสงค์
- ใช้เครื่องมือ URL Inspection ตรวจสอบหน้าสำคัญว่าสามารถเข้าถึงได้ปกติ
- ทดสอบระบบหลังการแก้ไขทุกครั้ง เพื่อยืนยันว่าไม่มีการปิดกั้นเส้นทางโดยไม่ตั้งใจ
ข้อผิดพลาดจากการตั้งค่า robots.txt สามารถส่งผลกระทบรุนแรงต่อโครงสร้าง Technical SEO โดยมีตัวอย่างปัญหาและผลกระทบที่ควรระวังดังนี้
ข้อผิดพลาดในการตั้งค่า | ผลกระทบที่อาจเกิดขึ้นกับ SEO |
ใช้ Disallow: / โดยไม่ตั้งใจ | บล็อกการ Crawl ทั้งเว็บไซต์สำหรับ Crawler ทั้งหมด ทำให้อันดับร่วงกราว |
บล็อกหน้าสินค้าหรือบริการ | Google ไม่สามารถเข้ามาสแกนเนื้อหาสำคัญ ส่งผลต่อการจัดอันดับคีย์เวิร์ด |
ใช้ Disallow แทน noindex | URL อาจยังคงปรากฏบนหน้าผลการค้นหาในรูปแบบลิงก์เปล่า ๆ |
บล็อกไฟล์ CSS หรือ JavaScript | ส่งผลให้การเรนเดอร์หน้าเว็บเพี้ยน บอทมองเห็นหน้าเว็บไม่สมบูรณ์ |
ตั้งค่า URL Path ผิดพลาด | บล็อกหรืออนุญาตเส้นทางผิดเพี้ยนไปจากเจตนาเดิม |
ใช้ robots.txt ซ่อนข้อมูลลับ | ไม่สามารถป้องกันความปลอดภัยได้จริง เพราะไฟล์นี้เปิดเป็นสาธารณะ |
การปรับแต่งไฟล์ robots.txt ในเว็บไซต์ที่มีผู้เข้าชมสูงหรือพึ่งพารายได้จาก Organic Search ควรผ่านการตรวจสอบอย่างรอบคอบจากรวม 10 เอเจนซี่การตลาดออนไลน์ที่ดีที่สุดในไทยที่มีทีมผู้เชี่ยวชาญด้าน Technical SEO เพื่อป้องกันความเสียหายในระยะยาว
สรุป
robots.txt คือเครื่องมือควบคุมการ Crawl ที่ช่วยให้ Search Engine ทราบกฎการเข้าถึงส่วนต่าง ๆ ของเว็บไซต์ แต่ไม่ใช่เครื่องมือป้องกันการทำดัชนีหรือปกป้องข้อมูลส่วนตัวโดยตรง การตั้งค่าที่เหมาะสมจึงต้องพิจารณาร่วมกับ Sitemap, noindex, Internal Linking และโครงสร้างเว็บไซต์
หากเว็บไซต์กำลังเผชิญปัญหา Googlebot เข้าไม่ถึงหน้าสำคัญ มีหน้าเว็บไม่ถูก Index หรือไม่แน่ใจว่า robots.txt ส่งผลต่อ Organic Performance หรือไม่ Convert Cake มี รับทำ SEO ครอบคลุมการตรวจสอบ Technical SEO และการวิเคราะห์โครงสร้างเว็บไซต์ เพื่อช่วยค้นหาปัญหาและวางแผนปรับปรุงได้อย่างเป็นระบบ
FAQ
robots.txt คืออะไร และจำเป็นต้องมีทุกเว็บไซต์หรือไม่?
robots.txt คือไฟล์ข้อความธรรมดาที่วางไว้หลังบ้านเพื่อกำหนดกฎให้ Crawler หรือบอทของ Search Engine ทราบว่าสามารถหรือห้ามเข้าถึง URL และเส้นทางใดบนเว็บไซต์ ทั้งนี้ ไม่จำเป็นต้องมีทุกเว็บไซต์ หากเป็นเว็บขนาดเล็กที่ไม่ได้มีความจำเป็นในการกักบริเวณการสแกนข้อมูลของบอทเป็นพิเศษ แต่สำหรับเว็บที่มีระบบซับซ้อน มีหน้าหลังบ้าน หรือหน้าค้นหาภายใน การมีไฟล์นี้จะช่วยบริหารจัดการ Crawl Budget ได้อย่างมีประสิทธิภาพ
robots.txt กับคำสั่ง noindex ต่างกันอย่างไร?
แม้เครื่องมือทั้งสองชนิดจะถูกนำมาใช้จัดการหน้าเว็บเหมือนกัน แต่กลับทำงานคนละกระบวนการอย่างสิ้นเชิง โดย robots.txt ทำหน้าที่ควบคุม การเข้าถึง (Crawling) เพื่อระบุกฎกักบริเวณ ไม่ให้บอทไต่เข้าไปสแกนหรืออ่านข้อมูลในพื้นที่ที่กำหนดบนเว็บไซต์ ในขณะที่ noindex ทำหน้าที่แจ้งคำสั่งตรงไปยัง Search Engine ว่า ไม่ให้ทำดัชนี (Indexing) เพื่อป้องกันไม่ให้หน้าเว็บดังกล่าวไปปรากฏบนหน้าผลการค้นหาของ Google ซึ่งบอทจำเป็นต้องสามารถไต่เข้าถึงหน้าเว็บเพื่ออ่านคำสั่ง noindex ได้อย่างถูกต้อง
หากใช้ robots.txt บล็อก Google แล้ว หน้าเว็บจะหายไปจากผลการค้นหาทันทีไหม?
ไม่เสมอไป เนื่องจาก robots.txt เพียงแค่บล็อกไม่ให้ Googlebot เข้าไปอ่านเนื้อหาข้างใน แต่หาก Google ค้นพบ URL นั้นจากลิงก์ภายนอกที่ชี้เข้ามา หน้าเว็บก็ยังสามารถปรากฏบนผลการค้นหาในลักษณะลิงก์เปล่าได้ หากต้องการป้องกันไม่ให้หน้าเว็บขึ้น Google อย่างเด็ดขาด ควรใช้คำสั่ง noindex บนหน้าที่เปิดให้บอทเข้าถึงได้ หรือใช้ระบบล็อกอินป้องกัน แทนการพึ่งพา robots.txt เพียงอย่างเดียว

Related Blogs
Sitemap คืออะไร ทำความรู้จัก XML Sitemap วิธีสร้าง และการส่ง Sitemap ให้ Google อย่างถูกต้อง
แนะนำ 5 เครื่องมือ SEO Tools ฟรีและเสียเงิน พร้อมสรุปจุดเด่นและราคาล่าสุด
